Multiple Sequence Alignments with r-gt!
This page reproduces work created by Victor Yuan for the 2025 Posit Table Contest: Visualizing Conserved Regions Across Coronavirus Spike Proteins (contest entry · source code). All credit for the original analysis and design goes to the author.
This submission won “Best gt Table” from the 2025 Table Contest by Posit
Multiple sequence alignment (MSA) is a computational technique to compare biological sequences, and identify regions of similarity and differences. This approach is used for identifying conserved functional domains, and understanding evolutionary relationships between related proteins.
For the 2025 Posit Table contest I wanted to explore how MSAs can be effectively visualized using the r package gt. This has been something I have wanted to do for a long time, and I’m excited to share this exploration.
The data we are working with is an MSA from (Wang et al. 2021), where they identified a potential universally conserved “weak spot” in Coronavirus spike proteins to specific cross-reactive monoclonal antibodies. The spike protein was the primary target for developing the COVID-19 vaccines, which crucially saved millions of lives during in the fight against the pandemic.
Figure 5 from their study presents an MSA comparing spike proteins from several coronavirus species: SARS-CoV, SARS-CoV-2, MERS-CoV, and HCoV-OC43 (which causes the common cold). This visualization left an immediate impression on me. Despite there being large divergence between these species, the authors were able to identify a region with enough similarity to serve as target for broadly reactive antibodies.
Let’s explore how we can leverage gt to better understand the evolutionary relationships between coronavirus protein sequences!
Visualizing Conserved Regions Across Coronvirus Spike Proteins
Click through the tabs below to explore each region of the coronavirus spike protein alignment in detail.
This is my re-creation of the multiple sequence alignment of coronavirus spike proteins
Code
base_table <- tbl_data |>
gt(rowname_col = c("name"), groupname_col = "group") |>
# add consensus sequence
grand_summary_rows(
columns = contains("pos"),
fns = list(
Consensus ~ get_consensus_return_bar(.) |>
div(style = "width:100%;height:50px;") |>
as.character(),
Sequence ~ names(get_consensus(.)) |>
# change to double dash, otherwise fmt_markdown turns it into a list (ul)
stringr::str_replace("-", "--")
),
fmt = list(
bar ~ fmt_markdown(.)
),
missing = ""
) |>
## style consensus sequence
### make sure that the consensus sequence elements are centered
tab_style(
style = cell_text(align = "center"),
locations = cells_grand_summary(columns = contains("pos_"))
) |>
tab_style(
style = cell_borders(sides = "bottom", style = "hidden"),
locations = list(
cells_grand_summary(rows = 1),
cells_stub_grand_summary(rows = 1)
)
) |>
# style the sequence elements: center elements, adjust size
tab_style(
style = cell_text(
size = "small",
align = "center",
indent = 0
),
locations = list(
cells_body(columns = contains("pos_")),
cells_grand_summary(columns = contains("pos_"))
)
) |>
cols_width(
1 ~ px(60),
name ~ px(50),
start ~ px(40),
everything() ~ px(13)
) |>
cols_align("right", group:start) |>
# breaks
cols_label_with(
fn = ~ ifelse(. %in% breaks, ., "") |> str_remove("pos_"),
columns = contains("pos_")
) |>
# remove borders from the table body
tab_style(
style = list(
cell_borders(
sides = "all",
weight = px(0)
)
),
locations = list(
cells_body()
)
) |>
# annotation regions in the alignment
tab_spanner(
columns = pos_1:pos_21,
label = "Stem helix"
) |>
tab_spanner(
columns = pos_33:pos_80,
label = "HR2 region"
) |>
tab_spanner(
columns = pos_91:pos_95,
label = "TM region"
) |>
# epitope
cols_label(
pos_14 ~ "*",
pos_15 ~ "",
pos_16 ~ "*",
pos_17 ~ "*",
pos_19 ~ "!",
) |>
# borders, style
tab_options(
row_group.as_column = TRUE,
table.font.size = 14,
# adjust padding in the cell body
data_row.padding.horizontal = px(2),
data_row.padding = px(2),
# adjust padding in the grand summary
# Noting that padding creates space between the bars (which have 100% width)
grand_summary_row.padding.horizontal = px(0),
grand_summary_row.padding = px(2),
# # remove borders
table.border.top.style = "hidden",
grand_summary_row.border.width = px(2)
)
base_table |>
gt::data_color(
columns = contains("pos_"),
fn = apply_color_to_aa(palette = "Chemistry")
)| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
This 95-amino-acid section contains several functionally important regions: the epitope where antibodies bind, the stem helix, heptad repeat region 2 (HR2), and the transmembrane domain (TM).
Click through the rest of these sections, as I use gt to help understand the amino acid composition of these regions in detail.
A note on the color palettes
MSAs commonly utilize colors to help readers better understand the variability in amino acid composition in biological sequences. Amino acids have all sorts of properties, such as hydrophobicity, size, and 3D structure. By coloring amino acids according to their biochemical properties, we can better understand the the variation in amino acid composition.
This color palette is from ggmsa that groups chemically-similar amino acids together:
- Acidic amino acids glutamic (E) and aspartic acid (D) are red
- Nonpolar/hydrophobic amino acids proline (P), alanine (A), valine (V), methionine (M), leucine (L), isoleucine (I), and glycine (G) are orange
- Basic amino acids lysine (K) and arginine (R) are blue
- Polar amino acids asparagine (N), threonine (T), cysteine (C), glutamine (Q), and serine (S) are green
- Aromatic amino acids phenylalanine (F), tyrosine (Y), and tryptophan (W) are yellow
In this analysis, I implemented a several alternative palettes and explore how effective they can be used to understand the amino acid composition of protein sequences.
The region where the antibodies bind
Code
base_table |>
gt::data_color(
columns = pos_11:pos_19,
fn = apply_color_to_aa(palette = "Chemistry")
) |>
annotate_rectangle(start = pos_11, end = pos_18)| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
At the end of the Stem Helix lies the Epitope region, which is a region where the antibodies 28D9/1.6C7 (the very creative names of the antibodies) bind to. This is where the magic happens. Referred to also as the “core epitope”, asterisk indicate where key amino acid positions are for this interaction. If these positions are replaced with other amino acids, the antibodies can no longer bind effectively.
How did the researchers determine this? By quite literally systematically changing each amino acid one at a time and measuring antibody binding. This mutagensis experiment importantly revealed that some amino acids in this region can change without affecting binding too much, but these 3 amino acids are critical.
The exclamation point marks an amino acid adjacent to the epitope, which the authors refer to as a “conserved glycosylation sequon”, or “NxS/T”. This means this is an amino acid that sugar can attach to, and it follows the pattern of “the amino acid N, followed by any amino acid X, and then either an S or a T”. Apparently this is a conserved pattern among coronavirus species. What’s significant here is the authors suggest that this sugar molecule may be potentially important for the binding of these antibodies to this epitope.
This type of domain forms a 3-dimensional spiral like structure
Code
base_table |>
gt::data_color(
columns = pos_1:pos_21,
fn = apply_color_to_aa(palette = "Shapely")
) |>
annotate_rectangle(start = pos_1, end = pos_21)| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
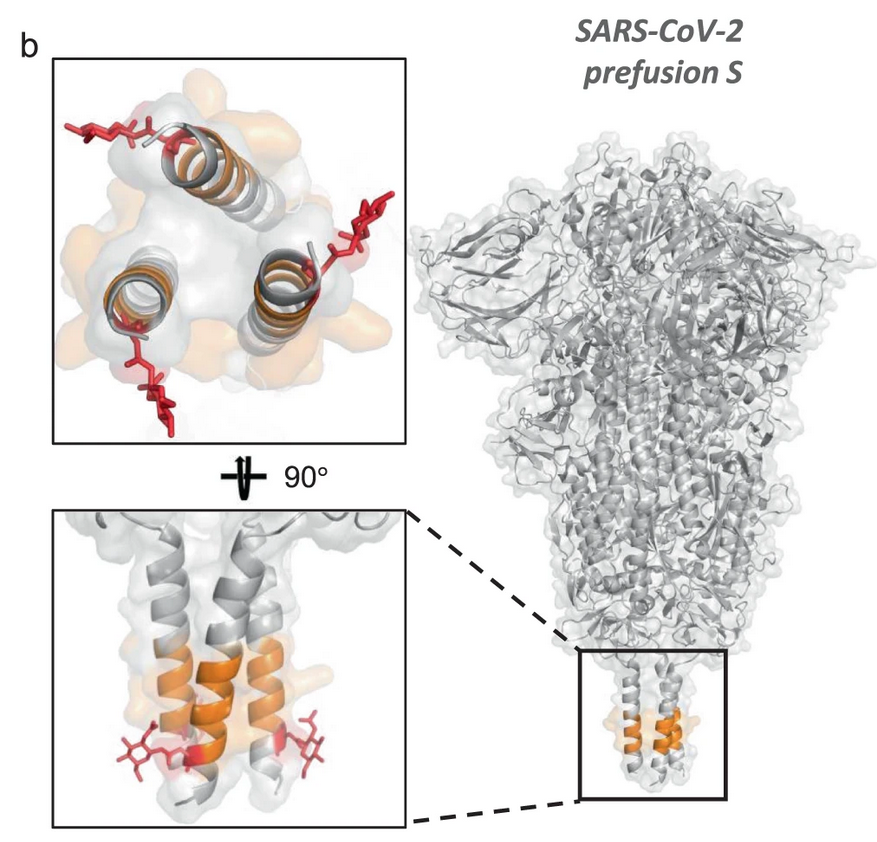
The Stem Helix is the orange part highlighted in this protein modeling figure.
 A color palette from the bioinformatic software Rasmol is shown here, which is based on Bob Fletterick’s “Shapely Models”.
HR2 stands for “Heptad Repeat Region 2”
Code
base_table |>
gt::data_color(
columns = pos_33:pos_80,
fn = apply_color_to_aa(palette = "LETTER")
) |>
annotate_rectangle(start = pos_33, end = pos_80)| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
The epitope occurs upstream of the Heptad Repeat Region 2 (HR2). Why is it called “Heptad Repeat”, because this is region where every 7 amino acids tends to be repeated.
Can you spot the pattern? (If you can, do let me know because I can’t)
We can adjust the palette to better identify the repeat pattern.
Code
base_table |>
gt::data_color(
columns = pos_33:pos_80,
fn = apply_color_to_aa(palette = "Hydrophobicity")
) |>
annotate_rectangle(start = pos_33, end = pos_80)| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
Heptad repeat regions are typically identified via 3D structural modelling. Meaning, the repetitive-ness of these regions are difficult to be observed when viewing linear amino acid sequences. The exact amino acid length of each repeat is also imperfect, and not necessarily is the same amino acid repeated, but just one that is highly similar - usually a hydrophobic amino acid (e.g. leucine, valine, phenylalanine). These typically occur at position 1 and 4 of each seven amino acid unit.
We can try to see this pattern using a color palette that highlights the relative hydrophobicity between amino acids.
This region anchors the protein to the outer-most membrane of the virus.
Code
base_table |>
gt::data_color(
columns = pos_91:pos_95,
fn = apply_color_to_aa(palette = "Taylor")
) |>
annotate_rectangle(start = pos_91, end = pos_95)| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
The final region is called the Transmembrane (TM) region, which is the part of the protein that spans across a phospholipid bilayer. It is an important structural component that anchors the spike protein to the viral envelope.
Because of the lipid-rich environment of this layer, TM regions contain many hyrophobic and nonpolar residues - such as tryptophan (W), tyrosine (Y), valine (V), and leucine (L).
This color palette Taylor is taken from the popular MSA program Jalview.
If you enjoyed this article and want to use some of these functions yourself, check out the development of gtseq
How it is built, step by step
The tabs above vary the palette and the highlighted region, but they all share one base_table. This section takes that table apart: each tab adds one piece of the pipeline on top of the previous one, so you can see what every part contributes. The code for each step is shown below its output.
The alignment arrives as one row per sequence with the residues in a single string. Splitting it into characters, numbering the positions, then pivoting wide gives one column per alignment position (pos_1 … pos_95), which is what lets gt treat residues as cells.
# A tibble: 8 × 12
group name start pos_1 pos_2 pos_3 pos_4 pos_5 pos_6 pos_7 pos_8 pos_9
<chr> <chr> <dbl> <chr> <chr> <chr> <chr> <chr> <chr> <chr> <chr> <chr>
1 beta OC43 1225 T S I P N L P D F
2 beta MHV 1191 T S I P N P P D F
3 beta HKU1 1226 H S V P K L S D F
4 beta SARS 1122 P L Q P E L D S F
5 beta SARS2 1140 P L Q P E L D S F
6 beta MERS 1223 L G N S T G I D F
7 alpha 229E 1025 T I V P E Y I D V
8 alpha NL63 1208 T V I P D Y V D V
tbl_data[, 1:12]gt() with rowname_col and groupname_col puts the virus names in the stub and groups them by species. The 95 position columns are far too wide at their default size, which the next steps fix.
| start | pos_1 | pos_2 | pos_3 | pos_4 | pos_5 | pos_6 | pos_7 | pos_8 | pos_9 | pos_10 | pos_11 | pos_12 | pos_13 | pos_14 | pos_15 | pos_16 | pos_17 | pos_18 | pos_19 | pos_20 | pos_21 | pos_22 | pos_23 | pos_24 | pos_25 | pos_26 | pos_27 | pos_28 | pos_29 | pos_30 | pos_31 | pos_32 | pos_33 | pos_34 | pos_35 | pos_36 | pos_37 | pos_38 | pos_39 | pos_40 | pos_41 | pos_42 | pos_43 | pos_44 | pos_45 | pos_46 | pos_47 | pos_48 | pos_49 | pos_50 | pos_51 | pos_52 | pos_53 | pos_54 | pos_55 | pos_56 | pos_57 | pos_58 | pos_59 | pos_60 | pos_61 | pos_62 | pos_63 | pos_64 | pos_65 | pos_66 | pos_67 | pos_68 | pos_69 | pos_70 | pos_71 | pos_72 | pos_73 | pos_74 | pos_75 | pos_76 | pos_77 | pos_78 | pos_79 | pos_80 | pos_81 | pos_82 | pos_83 | pos_84 | pos_85 | pos_86 | pos_87 | pos_88 | pos_89 | pos_90 | pos_91 | pos_92 | pos_93 | pos_94 | pos_95 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| beta | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| alpha | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V |
Squeezing every position column to 13px and centring the text is what makes the table read as an alignment: residues line up into vertical columns the eye can scan for conservation.
| start | pos_1 | pos_2 | pos_3 | pos_4 | pos_5 | pos_6 | pos_7 | pos_8 | pos_9 | pos_10 | pos_11 | pos_12 | pos_13 | pos_14 | pos_15 | pos_16 | pos_17 | pos_18 | pos_19 | pos_20 | pos_21 | pos_22 | pos_23 | pos_24 | pos_25 | pos_26 | pos_27 | pos_28 | pos_29 | pos_30 | pos_31 | pos_32 | pos_33 | pos_34 | pos_35 | pos_36 | pos_37 | pos_38 | pos_39 | pos_40 | pos_41 | pos_42 | pos_43 | pos_44 | pos_45 | pos_46 | pos_47 | pos_48 | pos_49 | pos_50 | pos_51 | pos_52 | pos_53 | pos_54 | pos_55 | pos_56 | pos_57 | pos_58 | pos_59 | pos_60 | pos_61 | pos_62 | pos_63 | pos_64 | pos_65 | pos_66 | pos_67 | pos_68 | pos_69 | pos_70 | pos_71 | pos_72 | pos_73 | pos_74 | pos_75 | pos_76 | pos_77 | pos_78 | pos_79 | pos_80 | pos_81 | pos_82 | pos_83 | pos_84 | pos_85 | pos_86 | pos_87 | pos_88 | pos_89 | pos_90 | pos_91 | pos_92 | pos_93 | pos_94 | pos_95 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| beta | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| alpha | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V |
m3 <- m2 |>
tab_style(
style = cell_text(size = "small", align = "center", indent = 0),
locations = cells_body(columns = contains("pos_"))
) |>
cols_width(
1 ~ px(60),
name ~ px(50),
start ~ px(40),
everything() ~ px(13)
) |>
cols_align("right", group:start)
m3The column labels are treated as an axis: generate_breaks() picks every fifth position and cols_label_with() blanks the rest, so the header behaves like axis ticks instead of 95 crowded numbers.
| start | 5 | 10 | 15 | 20 | 25 | 30 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 85 | 90 | 95 | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| beta | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| alpha | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V |
m4 <- m3 |>
cols_label_with(
fn = ~ ifelse(. %in% breaks, ., "") |> str_remove("pos_"),
columns = contains("pos_")
) |>
tab_style(
style = list(cell_borders(sides = "all", weight = px(0))),
locations = list(cells_body())
)
m4grand_summary_rows() adds two summary rows across every position column: the most frequent residue, and a bar whose height is that residue’s frequency. The bar is plain HTML from create_html_vertical_bar(), so conservation becomes a miniature profile plot along the bottom of the alignment.
| start | 5 | 10 | 15 | 20 | 25 | 30 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 85 | 90 | 95 | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| beta | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L |
| alpha | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V |
| Consensus | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | |
m5 <- m4 |>
grand_summary_rows(
columns = contains("pos"),
fns = list(
Consensus ~ get_consensus_return_bar(.) |>
div(style = "width:100%;height:50px;") |>
as.character(),
Sequence ~ names(get_consensus(.)) |>
stringr::str_replace("-", "--")
),
fmt = list(bar ~ fmt_markdown(.)),
missing = ""
) |>
tab_style(
style = cell_text(align = "center"),
locations = cells_grand_summary(columns = contains("pos_"))
) |>
tab_style(
style = cell_borders(sides = "bottom", style = "hidden"),
locations = list(
cells_grand_summary(rows = 1),
cells_stub_grand_summary(rows = 1)
)
) |>
tab_style(
style = cell_text(size = "small", align = "center", indent = 0),
locations = cells_grand_summary(columns = contains("pos_"))
)
m5Spanners name the functional regions (stem helix, HR2, TM), and relabelling five individual columns marks the critical epitope positions with asterisks and the glycosylation sequon with an exclamation mark. tab_options() then tightens the padding, which the consensus bars need in order to sit flush against each other. This is base_table.
| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
m6 <- m5 |>
tab_spanner(columns = pos_1:pos_21, label = "Stem helix") |>
tab_spanner(columns = pos_33:pos_80, label = "HR2 region") |>
tab_spanner(columns = pos_91:pos_95, label = "TM region") |>
cols_label(
pos_14 ~ "*",
pos_15 ~ "",
pos_16 ~ "*",
pos_17 ~ "*",
pos_19 ~ "!",
) |>
tab_options(
row_group.as_column = TRUE,
table.font.size = 14,
data_row.padding.horizontal = px(2),
data_row.padding = px(2),
grand_summary_row.padding.horizontal = px(0),
grand_summary_row.padding = px(2),
table.border.top.style = "hidden",
grand_summary_row.border.width = px(2)
)
m6data_color() with apply_color_to_aa() maps each residue letter to its colour in the chosen scheme. Because it is the very last step, the same base_table can be recoloured by palette or restricted to a region, which is exactly what the tabs earlier on the page do.
| start |
Stem helix
|
25 | 30 |
HR2 region
|
85 | 90 |
TM region
|
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5 | 10 | * | * | * | ! | 20 | 35 | 40 | 45 | 50 | 55 | 60 | 65 | 70 | 75 | 80 | 95 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| beta | OC43 | 1225 | T | S | I | P | N | L | P | D | F | K | E | E | L | D | Q | W | F | K | N | Q | T | S | - | V | A | P | D | L | S | L | D | Y | - | - | I | N | V | T | F | L | D | L | Q | V | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | L | Q | E | A | I | K | V | L | N | Q | S | Y | I | N | L | K | D | I | G | T | Y | E | Y | Y | V | K | W | P | W | Y | V | W | L |
| MHV | 1191 | T | S | I | P | N | P | P | D | F | K | E | E | L | D | Q | W | F | K | K | Q | T | S | - | I | A | P | D | L | S | L | D | F | E | K | L | N | V | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | R | I | Q | D | A | I | K | K | L | N | E | S | Y | I | N | L | K | E | V | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| HKU1 | 1226 | H | S | V | P | K | L | S | D | F | E | S | E | L | S | H | W | F | K | N | Q | T | S | - | I | A | P | N | L | T | L | N | L | H | T | I | N | A | T | F | L | D | L | Y | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | N | L | I | Q | E | S | K | L | S | L | N | N | S | Y | I | N | L | K | D | I | G | T | Y | E | M | Y | V | K | W | P | W | Y | V | W | L | |
| SARS | 1122 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | F | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | L | I | D | L | Q | E | L | G | K | Y | E | Q | Y | I | K | W | P | W | Y | V | W | L | |
| SARS2 | 1140 | P | L | Q | P | E | L | D | S | F | K | E | E | L | D | K | Y | F | K | N | H | T | S | - | P | D | V | D | L | G | - | D | I | S | G | I | N | A | S | V | V | N | I | Q | K | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | I | D | R | L | N | E | V | A | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| MERS | 1223 | L | G | N | S | T | G | I | D | F | Q | D | E | L | D | E | Y | F | K | N | V | S | T | - | S | I | P | N | F | G | - | S | L | T | Q | I | N | T | T | L | L | D | L | T | Y | - | - | - | - | - | - | - | - | - | - | - | - | - | - | E | M | L | S | L | Q | Q | V | V | K | A | L | N | E | S | Y | I | D | L | K | E | L | G | N | Y | T | Y | Y | N | K | W | P | W | Y | I | W | L | |
| alpha | 229E | 1025 | T | I | V | P | E | Y | I | D | V | N | K | T | L | Q | E | L | S | Y | K | L | P | N | Y | T | V | P | D | L | - | - | V | V | E | Q | Y | N | Q | T | I | L | N | L | T | S | E | I | S | T | L | E | N | K | S | A | E | L | N | Y | T | V | Q | K | L | Q | T | L | I | D | N | I | N | S | T | L | V | D | L | K | W | L | N | R | V | E | T | Y | I | K | W | P | W | Y | V | W | V |
| NL63 | 1208 | T | V | I | P | D | Y | V | D | V | N | K | T | L | Q | E | F | A | Q | N | L | P | K | Y | V | K | P | N | F | - | - | D | L | T | P | F | N | L | T | Y | L | N | L | S | S | E | L | K | Q | L | E | A | K | T | A | S | L | F | Q | T | T | V | E | L | Q | G | L | I | D | Q | I | N | S | T | Y | V | D | L | K | L | L | N | R | F | E | N | Y | I | K | W | P | W | Y | V | W | V | |
| Consensus | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Sequence | T | S | I | P | E | L | D | D | F | K | E | E | L | D | E | W | F | K | N | Q | T | S | – | I | A | P | D | L | G | – | D | L | E | G | I | N | A | T | F | L | D | L | Q | Y | – | – | – | – | – | – | – | – | – | – | – | – | – | – | E | M | N | R | L | Q | E | V | I | K | N | L | N | E | S | Y | I | D | L | K | E | L | G | T | Y | E | Y | Y | I | K | W | P | W | Y | V | W | L | ||
m6 |>
gt::data_color(
columns = contains("pos_"),
fn = apply_color_to_aa(palette = "Chemistry")
)